

9月29日、電力計画設計総院は北京にて6冊のシンクタンク成果物を発表した。そのうち『人工知能とエネルギーの双方向エンパワーメントトレンド展望』は初めて公開された報告書である。報告書に繰り返し引用されている数値がある。2026年6月時点で、国内エネルギー企業は既に20以上の専門大規模モデルを公開している。
多くの人が「AI+エネルギー」と聞くと、データセンターの消費電力が大きく、エネルギーが一方的に演算処理能力を支えている、と考えがちだ。だがこれは「双方向エンパワーメント」の半分に過ぎない。もう一方の流れはその逆である。人工知能が発電、送電、受電機器の内部に入り込み、予測、診断、運転最適化を人に代わって実行するようになっている。報告書の中の一節はじっくり考える価値がある――人工知能の応用を「モデル駆動」から「シナリオ牽引」へ転換させ、限られた演算資源を高頻度・高価値・定量化可能・検証可能な業務プロセスに集中させる。
平易に言い換えれば、大規模モデルは見せかけのものではなく、最終的に個々の電源機器に落とし込み、機器の現在の状態の良し悪し、事前点検の要否、出力調整の必要性を判断させる必要がある。AIが「レポート作成アシスタント」から「機器の判断を代行する役割」へ変わるとき、基礎的だが見落とされがちな課題が浮上する。判断の根拠となるデータそのものは信頼できるのか、という問題である。
「AIが電源の判断を代行する」仕組みを分解してみよう。
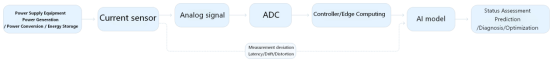
上位に何層ものアルゴリズムが重なっていても、完全な判断連鎖は次の通りである。機器内部の電流がセンサーによって測定され電気信号に変換され、A/Dコンバーターでデジタルデータへ変換された後、コントローラーと上位モデルへ伝送される。モデルが結論を算出し、最後に指令が出力される。予知保全も適応制御も同じ仕組みである。
この連鎖には見落とされやすい特徴がある。後段に進むほど「知的」になるが、後続のすべてのプロセスの入力元は、最前段の物理的測定に由来する。モデルは複雑な法則をフィッティングし、膨大なデータからパターンを発見できるが、入力段階で生じた偏差を勝手に補正することはできない。入力された波形に遅延やゼロ点オフセットが生じ、急激な変化が捉えられていない場合、モデルが精緻に計算すればするほど、誤った前提から一見筋の通った結論を導き出してしまう。
これはアルゴリズムの能力の問題ではなく、情報発生源の信頼性の課題である。データ品質はモデルの判断の信頼性に直接影響し、モデルが取得できる情報の上限を制約する。
したがって報告書が資源を「定量化可能・検証可能」なプロセスに集中するよう強調する際、最初に検証を確保すべきなのは、根底の電流データである。この部分は目立たないが、後続のすべての知的判断の成否を左右する。
では、大規模モデルの判断の元データとして適した、信頼できる電流データとは何か。大電力電源の実際の動作状況を踏まえ、少なくとも三つのハードルをクリアする必要がある。
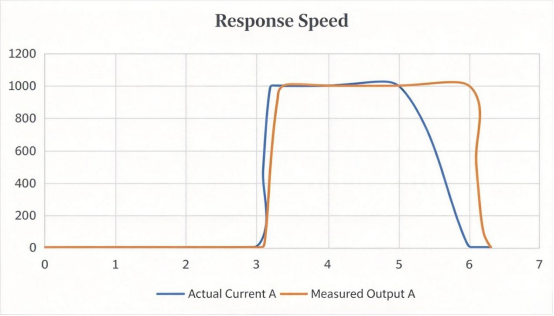
第一に、発生した変化を遅れなく捉えることである。電源機器の電流はなだらかな直線ではない。負荷切り替え、指令調整、故障発生の瞬間、電流は極めて短時間で大きく変動する。AIによる予測や保護判断の根拠は、多くの場合こうした急変の細部にある。測定自体の応答が鈍いと、変化が測定値に反映されたときには重要なタイミングが過ぎ去っている。モデルに入力されるのは「遅延した波形」となり、時間軸に敏感な判断は歪んでしまう。
第二に、ゼロ点が安定し、測定自体の偏差を機器の異常と誤認しないことである。これは予知保全において特に重要だ。予知処理の多くは、長期データの中からゆっくり生じる小さなオフセット――部品の経年劣化や電流に混入する異常成分など――を識別する作業である。こうした判断には測定のゼロ点安定性が強く求められる。測定点自身のゼロ点が温度によってドリフトすると、機器が正常でもデータが緩やかに変動し、モデルは測定器のドリフトを機器の異常と誤判して不要なアラームを出力する。逆に真の小さな異常がドリフトによって隠れてしまう場合もある。誤報と見落としの原因はここにあることが多い。
第三に、測定値が正確で線形性に優れ、かつ測定を追加することで機器本体に影響を与えないことである。電源機器では「測れる」だけでなく「正確に測れる」こと、そして測定に伴う代償の有無が重要となる。大電流主回路において、被測定電流をサンプリング素子に通す方式を採用する場合、追加の電圧降下、消費電力、発熱を設計に考慮しなければならない。非接触型電流センサーは主回路を切断せずに電流情報を取得でき、主回路に直列の測定素子を追加するデメリットを回避できる。
この三つの条件をまとめると、AIに渡す電流データは「追従性が良く、ゼロ点が安定し、測定精度が高く、取得コストが小さい」ことが求められる、という一言になる。
上記三条件を同時に満たすには、電流の測定原理に立ち返る必要がある。閉ループゼロ磁束方式の特徴が、先の三つのハードルにちょうど対応する。
CR8Aシリーズのような閉ループホールセンサーは補償式動作原理を採用しており、帰還電流によって一次側電流が生み出す磁界を相殺し、磁気コアの動作点をゼロ磁束付近に維持する。被測定電流が磁気コアを貫通すると磁界が発生する。センサーの補償巻線に対し、ホール素子が検知した磁束に基づいて回路がリアルタイムで逆方向電流を流し、一次側の磁界を打ち消して磁気コアの磁束を常にゼロ点に戻す。補償電流を巻線の巻数比で換算することで一次側電流を求める。
この仕組みがもたらす効果は以下の通りである。
まず応答速度が速く、周波数帯域が広い。これはリアルタイム負帰還プロセスであり、一次側電流が変化すると補償回路が即座に動作して相殺するため、磁気コアは磁束を持った状態に留まらない。芯森電子の同製品の場合、電流ステップ入力に対する応答時間は1マイクロ秒以下、帯域幅は100キロヘルツに達する。負荷切り替えや故障発生時の急激な変化にほぼ同期して追従でき、モデルへ入力する波形に遅れが生じない。これは第一の条件に対応する。
次に、ゼロ点と線形性が本質的に安定している。開ループ方式では磁気コアに磁束が残留する状態で動作するため、出力は磁性材料とホール素子自体の線形性に依存し、温度変化や大電流印加後に残留磁束が残りやすく、ゼロ点の管理に手間がかかる。閉ループ補償により磁気コアはゼロ磁束付近で動作するため、開ループと比べ磁気ヒステリシスや残留磁束といった非線形要因の影響を大きく抑えられる。CR8Aシリーズは定格点における精度0.3%、線形性誤差0.1%を実現している。長期運転機器ではゼロ点安定性も重要である。測定器自身のゼロ点ドリフトが小さければ、長期データに現れる緩やかな変化が測定誤差に汚染されにくくなる。トレンド分析や状態監視システムにおいてこの点は極めて重要である。測定点自体が全温度域で安定しているからこそ、モデルが長期データから読み取る緩やかな変化が、測定点の温度変動ではなく機器自身の変化である可能性が高まる。これは第二の条件に対応する。
最後に、一次側非接触測定であり、主回路にサンプリング抵抗などの測定素子を直列に挿入しない。そのため直列サンプリング方式のような追加の電圧降下や消費電力が発生しない。絶縁耐圧は6000ボルト、サージ耐圧は23000ボルトであり、確実な電気的絶縁を実現している。これは第三の条件に対応する。
閉ループゼロ磁束方式は特定の単一性能だけが突出しているのではない。原理そのものが「追従性、ゼロ点安定性、測定精度、低コスト」の四つの要件を同時に満たす。AIの判断連鎖の最前のデータソースとして採用することで、連鎖全体の基礎を堅固なものにできる。
データの信頼性確保には、混同されがちな課題がもう一つある。測定点のレンジを機器の実際の電流分布に合わせることである。ここで定格電流と測定範囲は同一の概念ではないことを強調しておく。
定格電流はセンサーの定格動作条件に対応し、測定範囲はセンサーが測定可能な電流区間を示す。両者の関係は仕様書と実際の動作状況を踏まえて判断する必要があり、「定格値超過は短時間しか使えない」と単純に理解してはならない。仕様上、短時間過電流に対応する余裕が確保されている。例えばCR8A 1000Aモデルの場合、定格電流1000Aに対し測定範囲は±1500Aである。機器の定常連続運転電流は定格電流付近とし、起動や負荷急変時の短時間ピーク電流はより広い測定範囲内に収めることで、測定値が飽和して切れてしまう現象を回避できる。
この点はAI活用シーンで特に重要である。異常検知や状態診断など波形特徴に依存するアルゴリズムでは、短時間ピークや過渡現象も重要な情報となり得る。レンジが小さすぎると過電流時に波形が切れ、モデルはピーク値を把握できず重要な特徴を見落とす。逆にレンジが過大だと、通常動作電流がフルスケールのごく一部となり、分解能が無駄になる。
したがって機器選定は二つの軸で考える。連続通電電流は定格電流に合わせ、短時間ピークは測定範囲を超えないようにする。具体的なピーク値は機器と制御ロジックの実測波形をもとに判断し、大雑把な数値を当てはめてはならない。
ここで役割の境界線を明確にしておく必要がある。過大な期待をかけないためだ。
AIによる判断の連鎖において、電流センサーの役割は明確である。一次側の電流を正確、リアルタイム、安定的に信号へ変換して出力するだけで、予測を行わず、結論を出さず、点検や出力調整の要否も決定しない。これらの判断はコントローラーと上位モデルがデータに基づいて実行し、重要な意思決定は長期的に専門家が担う、いわゆる「AI補助、人間が最終判断」の仕組みである。
だがセンサーは最前段に位置するからこそ、その責任は軽視できない。モデルの価値は信頼できるデータから知見を引き出すことにある。元データが歪んでいれば、高性能なモデルも誤った信号に対して複雑な演算を行うだけになり、AIを使わない場合より危険になる可能性さえある。明らかなエラーを出力するシステムであれば人が確認するが、誤ったデータに基づき「一見妥当に見える結論」を出すシステムは、人の警戒心を緩めやすい。
20以上のエネルギー大規模モデルが次々と登場し、AIが電源機器の現場に浸透し始めている今、新たなモデルを追加するよりも先に確認すべきことがある。これらの判断を支える電流データは本当に信頼できるのか、という点だ。
データ発生源を堅固に整備してこそ、上位の「定量化可能・検証可能」な知的機能は実装可能になる。エネルギーとAIの双方向エンパワーメントは、一台一台の大電力電源機器レベルではごく単純な起点から始まる――AIに真の電流を見せてあげて初めて、人に代わって正しい判断ができるようになるのだ。